
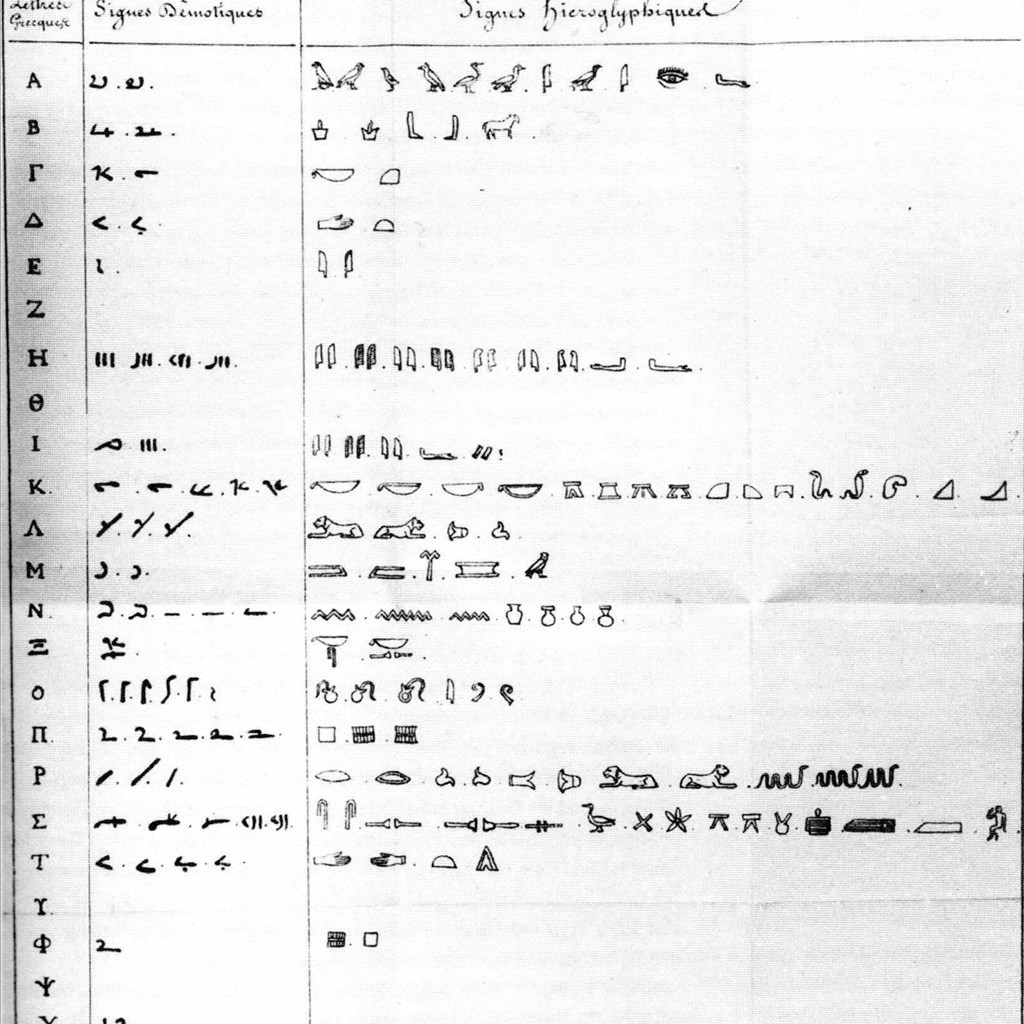
もし単純な置換暗号なら、ロゼッタ・ストーンだけで話は終わる
ロゼッタ・ストーンには読めるGreekがある。
未知のHieroglyphicがある。
同じ勅令を伝えている。
ここまで聞くと、問題は単純な換字暗号に見えるかもしれない。
Greekの文字Aに対応するHieroglyph Xを探す。
Greekの文字Bに対応するHieroglyph Yを探す。
十分な対応を集めれば、alphabetのような表が完成する。
もしEgyptian hieroglyphic writingが本当にその構造だけでできていたなら、解読はもっと短い問題だったはずである。
しかし実際のwriting systemは、phonogram、logogram、determinativeという異なる機能を持つsignを組み合わせる。
しかもphonogram itselfも、一記号一子音だけではない。
この構造を理解しないと、「Youngが音価を見つけた」「Champollionが表音原理を広げた」という成果が、なぜそれだけでは完全解読にならなかったのかが分からない。
ここが、解読の技術的な核心である。
Phonogram――記号がsoundを担う
phonogramは、soundを表すsignである。
ここまでのYoungとChampollionの検討で追ったphonetic valuesは、この機能に関係する。
王名の中でsignをknown nameのsoundと対応させることができれば、あるhieroglyphが単なるpicture-symbolではなくphonetic functionを持つことが分かる。
ただし、phonogramをmodern alphabetの一文字と同じだと考えるのは早い。
UCL Digital Egyptの解説は、phonetic signsがone, two or three consonantsを表し得ることを示している。
この違いは、専門用語ではuniliteral、biliteral、triliteralと呼べる。
uniliteral
= 1 consonantを表すphonogram

biliteral
= 2 consonantsを表すphonogram

triliteral
= 3 consonantsを表すphonogram
この三語は、名前だけ覚えても仕組みを理解したことにはならない。
重要なのは、「phonogramだから一sign一音」とは限らないという点である。
一記号一音ではない――sign countとsound countを分ける
仮に一つのHieroglyphが二つや三つのconsonantsを担えるなら、Greek letter一文字とHieroglyph一記号を横に並べる方式では説明できない。
同じwordを表すために必要なsign数も単純には一致しない。
一つのscriptで複数文字になる音のまとまりが、別scriptでは一つのsignで表される可能性がある。
だからparallel textを比較するとき、文字数が同じであることを前提にしてはいけない。
二言語・三文字体系を扱った回で「parallel textはword-for-word correspondenceではない」とした理由が、ここでさらに明確になる。
writing systemの単位そのものが同じではないからだ。
解読では、記号の見た目や数を合わせるだけでなく、そのsignが何個分のsound informationを担うかまで考えなければならない。
simple substitutionでは、symbol数と置換後の文字数を対応させたくなる。
しかしbiliteral / triliteral phonogramがある時点で、その前提は崩れる。
一つのsignが複数consonants分のphonetic informationを担える。
さらにdeterminativeのように、sound countへ入らないがmeaningを補助するsignもある。
つまり、目に見えるsignの個数を数えても、それだけではspoken sequenceの単位数やsemantic informationの単位数を決められない。
この点も、parallel textを一語ずつ機械的にalignmentできない理由の一つとして理解できる。
Logogram――signがword / conceptを担う
hieroglyphic writingには、phonogramとは別にlogogramとして働くsignがある。
logogramでは、signがsound sequenceの一部としてだけでなく、wordやconceptに対応する機能を持つ。
この点が、hieroglyphic signsの「絵のような見た目」と結びつきやすい。
しかし注意したいのは、絵の形をしたsignが常にlogogramになるわけではないことだ。
同じwriting systemの中で、signは文脈に応じて異なる機能を持ち得る。
だから「鳥の絵=鳥というword」「目の絵=見るという意味」と形だけから決める方法では解読にならない。
必要なのは、実際のword structureの中で、そのsignがどう使われているかを確認することである。
phonetic comparisonが重要だった理由もここにある。
見た目から意味を連想するのではなく、known nameや言語上の手掛かりからsign functionを制約できる。
Determinative――soundを読まないが、意味を絞る
三つ目がdeterminativeである。
Fitzwilliam MuseumとUCLの解説は、determinativeがwordの意味を明確にしたり、general significanceを示したりする機能を持つと説明する。
determinativeは、発音しない意味分類・意味補助の記号として働く。
この機能は、単純なcipher modelをさらに崩す。
もしtextに現れるsignすべてをsoundへ変換しようとすると、determinativeまで発音対象にしてしまう。
すると、phonetic readingが不自然になる。
逆に、どのsignがdeterminativeとしてsemantic categoryを示しているか分かれば、同じsound patternを持つwordの意味を区別する手掛かりになる。
つまりdeterminativeは「読まないから不要な記号」ではない。
sound informationとは別種類のinformationをtextへ加える。
三機能が同じwriting systemに共存する
図で最も重要なのは、三つを別々の時代や別々のアルファベットとして分けないことである。
phonogram
= sound information

logogram
= word / concept information

determinative
= semantic classification / clarification
これらが同じhieroglyphic writing systemの中に共存する。
ここに「単純な置換暗号ではない」というArticle titleの答えがある。
cipher tableなら、基本的には入力symbolを別symbolへ一対一で置き換える規則を想像できる。
しかしhieroglyphic writingでは、まずsign functionを判定する必要がある。
phonogramならsoundを読む。
logogramならword / conceptとの関係を見る。
determinativeならsemantic 役割を見る。
同じ「記号」として見えていても、解読時の処理が違う。
phonetic breakthroughだけではsystemが完成しない理由
Champollionは表音原理を外国王名の外へ広げた。
それは巨大なbreakthroughだった。
しかしphonetic signsが広く使われると分かっても、すべてのsignがphonetic signになるわけではない。
ここを混同すると、1822年を「alphabetを発見して終了」と説明してしまう。
実際には、phonetic principleが分かったことで初めて、残るsignの役割をsystemとして整理する問題がはっきりする。
なぜsoundだけでは説明できないsignがあるのか。
どのsignがwordを直接担うのか。
どのsignがmeaningを分類するのか。
こうした問いが、1824年のPrécisへつながる。
1822と1824を分ける意味は、chronologyだけでなく研究課題のlevelが変わることにある。
一つのwordにsound layerとmeaning layerが重なる
hieroglyphic writingの難しさを理解するには、textを「lettersの列」とだけ考えない方がよい。
wordを読むとき、sound informationがあり、word-level informationがあり、semantic classificationがある。
それらがsign sequenceの中で組み合わされる。
この構造では、signを一つずつ独立に翻訳しても、whole wordの働きが分からない場合がある。
逆に、wordのcandidateが分かると、各signの役割を推定しやすくなる。
だから解読はbottom-upだけでもtop-downだけでもない。
sign valueからwordを作り、known languageからword candidateを考え、別textで再確認する。
複数levelを往復する作業になる。
phonogramだけを見れば、writingはsoundを記録するsystemに見える。
logogramやdeterminativeを見ると、meaning側のinformationもsign sequenceへ直接組み込まれていることが分かる。
ここで重要なのは、soundとmeaningを対立させないことだ。
Egyptian hieroglyphic writingでは、両者が同じtextの中で協働する。
phonetic readingがwordのsoundへ近づける。
logogramがword / conceptを担う。
determinativeがsemantic categoryを補助する。
複数の機能が重なるため、解読者は「どう発音するか」だけでなく「どんな語として機能するか」も検討しなければならない。
だからphonetic breakthroughは不可欠だが、それだけでsystem descriptionは終わらない。
uniliteral / biliteral / triliteralを「文字数」の話だけにしない
一子音、二子音、三子音を表すphonogramという分類は、単なる専門用語ではない。
これを理解すると、なぜ同じsound sequenceを複数の方法で書ける可能性があるのか、なぜsign countとsound countを単純対応させられないのかが分かる。
重要なのは、modern alphabetを基準に「二子音signは二文字が合体したもの」と決めつけないことだ。
三者は、エジプト文字体系の内部で異なる機能を担う。
図では、この三分類を短い説明とともに整理できる。
中心となるのはphonogram / logogram / determinativeの三機能である。uniliteralなどの区分は、その仕組みを理解するための補助として位置づけられる。
phonetic complement――同じsoundを重ねて書くことがある
uniliteral / biliteral / triliteralという分類を知ると、さらに一つsimple substitutionから離れる仕組みが見える。UCLのworked exampleは、二つ以上のconsonantsを含むphonetic signのそばに、その中のsoundをもう一度示すsingle-consonant signが置かれることがあると説明している。
このsingle-consonant signは、毎回新しいsoundを一つ追加するとは限らない。multi-consonant signにすでに含まれるsoundを“reminder”として繰り返す場合がある。UCLはこれをphonetic complementと呼び、single-consonant signsの頻繁な用法の一つとしている。
このruleを知らずにsignを一個ずつalphabet letterへ置換すると、同じsoundを二回数える危険がある。
たとえば、 「signが二個あるからsoundも二単位増える」 とは限らない。
一方のsignが二consonantsを含み、もう一方がその一部を補ってreaderへreadingを明確にしている可能性がある。
ここでRamessesの分析が技術的に接続する。Champollionが一音と考えた記号が後には*ms*という二子音記号だと理解され、後続の*s*は読みに補助的に加わるものと説明できる。突破の過程そのものが、単純なアルファベットモデルから複合的な文字体系へ理解が深まる例になっている。
Determinativeがあると、soundだけ同じでも意味を区別できる
determinativeの存在は、文字とlanguageの関係を考えるうえで非常に示唆的である。
sound sequenceをphonetic signsから読めたとしても、それだけではwordのmeaningを一意に決めにくい場合がある。
そこでsemantic classifierとしてのsignがmeaningの領域を補助する。
この構造は、「読む=発音する」だけでは不十分であることを示す。
languageを理解するにはsoundとmeaningの両方が必要で、writing systemはその両方に異なる方法でinformationを持たせている。
だから解読を、単なる表音転写の成功として終わらせることはできない。
soundを取り出し、wordとして認識し、meaningを区別するsystemの理解まで視野に入れる。
一つのwordの中にsoundとsemantic classが共存する具体例
UCLのintroductory materialは、sound signとdeterminativeが一つのwordの中でどう共存するかをworked exampleで示している。
EgyptianでAnubisのnameを書く例では、consonantal sequenceを担うphonetic signsの後ろに、jackal on a shrineのsignが置かれる。その最後のsignは、前のphonetic sequenceへ新しいsoundを足すためではなく、wordが指す対象・semantic areaを明確にするdeterminativeとして機能する。
この構造を抽象語だけでなく操作として見ると、なぜphonogram / logogram / determinativeを分ける必要があるかが分かる。
readerはまずphonetic signsからsound patternを得る。 次にdeterminativeからsemantic classificationを得る。 場合によってはlogogramがword-level informationを直接担う。 さらにphonetic complementがmulti-consonant signのreadingを補助する。
つまり一つのwritten sequenceに、sound value、word value、semantic classification、reading aidが重ねられる。
このため、ヒエログリフを「絵をアルファベットの文字へ置き換える暗号」として扱うと、情報の種類そのものを取り違える。図で三つの主要機能を整理し、phonetic complementのような具体例を見ると、その機能が実際の読解でどう組み合わさるかが分かる。
Logogramとpicture-symbolを混同しない
logogramがconceptやwordを担うと聞くと、「やはりhieroglyphはpicture writingだった」と戻りたくなる。
しかしこれは逆戻りである。
hieroglyphic signがlogogramとして働く場合があることと、すべてのsignが絵の意味を直接表すことは同じではない。
phonogramもある。
determinativeもある。
さらにphonogramには複数consonantsを担うものがある。
つまりsystemの一部だけを全体へ一般化してはいけない。
Youngの時代にphonetic signsが見つかったからといって「全部alphabet」ではないのと同様、logogramがあるからといって「全部ideogram」でもない。
混合的な機能構造こそが本体である。
Rosetta Stone aloneでは、この混合systemを完全には証明できない
Rosetta Stoneはknown GreekとEgyptian scriptsを比較できるため、phonetic hypothesisを作る大きな足場になった。
しかしwriting systemの機能を一般化するには、other inscriptionsで同じ規則を確認する必要がある。
博物館や研究機関の資料をたどると、Champollionの前進がRosetta Stoneだけでなく、他の碑文とCopticを組み合わせた研究だったことが分かる。
この点は、解読の仕組みを理解するうえで重要である。
一つのparallel textから得た対応を、別のname、別のinscription、別のwordへ適用する。
そこで同じsign functionが再現する。
そうして初めて、「Rosetta Stoneの特殊な書き方」ではなく、Egyptian writing systemのruleとして説明できる。
ロゼッタ・ストーンが突破口でありながら、aloneでは完全解読にならなかった理由がここにある。
「解読」とは、sign tableを埋めることではない
もし解読のゴールを「各signに日本語の意味を書き込むこと」と考えると、hieroglyphic systemの本質を外す。
同じsignでも、system内の役割を見なければならない。
phonogramとしてsoundを担う。
logogramとしてwordを担う。
determinativeとしてmeaningを補助する。
そしてphonogramでも一・二・三consonantsを担うものがある。
したがって解読のゴールは、signの一覧を作ることではなく、signが組み合わされてlanguageを表すruleを再構成することである。
この視点に立つと、Champollionの1824 Précisが「system」を題名に持つ意味も理解しやすい。
図で整理する三つの機能
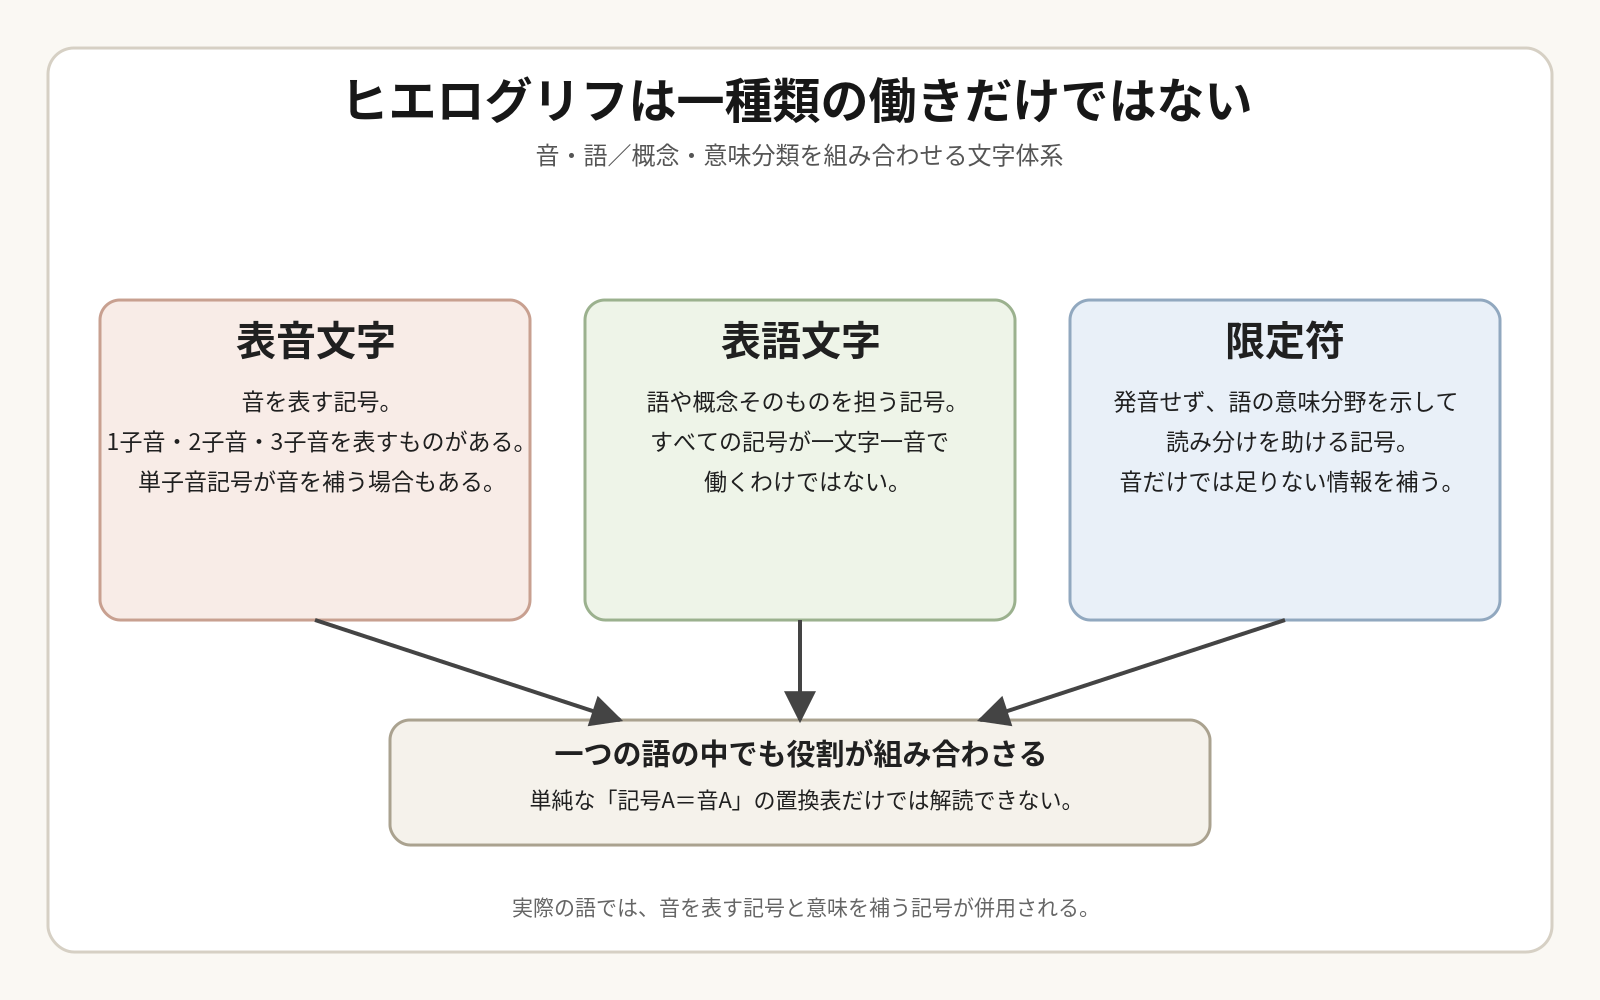
図は文章をそのまま置き換えるものではない。
三つの機能を一目で分けると、それぞれが同じ文字体系の中で異なる役割を持つことが見えやすい。
PHONOGRAM
sound
└─ 1 / 2 / 3 consonants

LOGOGRAM
word / concept

DETERMINATIVE
semantic classification
図ではこの役割差に集中する。
「どの有名なsignがどれに該当するか」というcatalogueにはしない。
個別signを増やすには追加証拠とvisual verificationが必要になるからだ。
重要なのは、なぜこの機能差によって単純置換が成り立たなくなるのかである。
図で機能の違いを整理すると、文字列を読むときに音と意味の双方を追う必要があることが見えやすくなる。
読解では、signの形より先に「役割」を問う必要がある
hieroglyphを見ると、まず形が目に入る。
しかしsystemを理解した後の読解では、「何の絵に見えるか」より、「この位置で何のfunctionを担っているか」を問う必要がある。
phonogramとして使われているならsound informationを読む。
determinativeならsemantic classificationを読む。
この順序を逆にして、形の印象から意味を決めると、記号を象徴として自由に解釈する方法へ戻ってしまう。
deciphermentの成果は、signを見た瞬間の連想ではなく、contextの中でfunctionを判定できるruleを持ったことにある。
文字体系の説明にも、なお残る別の問題がある
phonogramが一つ、二つ、三つの子音を表しうること、logogramとdeterminativeが別の機能を担うことだけでも、ヒエログリフが単純な一文字一音のalphabetではないことは分かる。
一方、古代エジプト語が実際にどのような母音を伴って発音されていたかは、こうした記号機能だけから機械的に復元できる問題ではない。子音を中心に書かれた情報と、後代の言語資料から推定する発音を同じものとして扱えば、書記体系の説明と発音復元の問題が混ざってしまう。
ここで押さえるべきなのは、signが担う役割である。音を示すsign、語を担うsign、意味領域を示すsignが同じwordの中で協働する。その仕組みを理解するだけでも、「Greek文字とhieroglyphを一対一で置き換えれば読める」というモデルが成り立たない理由は十分に見えてくる。
突破口は「対応表」ではなくsystem理解への入口だった
ロゼッタ・ストーンは、known Greekをanchorにしてunknown Egyptian scriptsへ比較を伸ばす条件を作った。
Youngはそこから一部phonetic valuesへ進んだ。
Champollionはphonetic principleをnative Egyptian materialへ広げた。
しかし、その先で見えてきたのは単純なalphabetではなかった。
logogram。
sound、word、meaning classificationを異なるsign functionで組み合わせるwriting systemだった。
ここから導かれる技術的な答えは明確である。
Rosetta Stoneは、GreekからHieroglyphを一文字ずつ置換する表を与えたのではない。比較可能な証拠を与え、そこから文字体系の複数機能を検証する道を開いた。
しかし、物語は文字体系の説明だけでは終わらない。
1822のbreakthroughから1824のPrécisへ進み、解読が「個々のsignを読むこと」から「古代Egyptian textsをlanguageとして扱うこと」へどんな変化をもたらしたのかを見る。
そしてYoung、predecessors、Champollionを一人の英雄物語ではなく、連続した研究史としてSeries全体を閉じる。
参考文献
検証ノート
確認した事項:ヒエログリフが音・語・意味補助の複数機能を持つ体系である点。[1][2][3]
資料の読み分け:公的・博物館・公文書・査読資料が一致する範囲をSUPPORTEDとして採用した。単純な一対一置換暗号として説明せず、時代・綴りによる変動余地を残した。
直接引用:本記事では原文の長い直接引用を追加せず、検証可能な範囲を要約し、出典との対応を示した。